读完这篇你能:用 grep 过滤、sed 替换、awk 按列统计。
前置:shell 基础。约 40 分钟。
三剑客的特点及应用场景
| 命令 | 特点 | 场景 |
|---|---|---|
| grep | 过滤 | grep命令过滤速度是最快的 |
| sed | 替换,修改文件内容,取行 | |
| awk | 取列,统计计算 | 非常擅长统计计算 |
grep
| 选项 | 含义 |
|---|---|
| -E | 支持扩展正则 |
| -A | after, -A 5 显示匹配行以及接下来的5行 |
| -B | before |
| -C | context 上下 |
| -v | 排除关键字 |
| -w | 精确匹配 |
sed
特点及格式
- 特点:sed stream editor流编辑器,可以把sed编辑的内容当做水流,对于文件是一行一行加载的
- 选项
| 选项 | 说明 |
|---|---|
-n |
禁止默认输出(仅输出处理后的内容) |
-e |
允许执行多个编辑命令(可省略,默认用分号分隔命令) |
-i |
直接修改原文件(谨慎使用!建议先备份) |
-r |
启用扩展正则表达式(等价于 egrep 的正则语法) |
-f |
从文件中读取编辑命令 |
-s |
独立处理每个文件(默认将多个文件视为一个流) |
- Sed命令核心功能:增删改查
| 命令 | 说明 | 示例 |
|---|---|---|
p |
打印匹配行 | sed -n '2p' file.txt:打印第 2 行 sed -n '/pattern/p' file.txt:打印包含 “pattern” 的行 |
d |
删除匹配行 | sed '1d' file.txt:删除第 1 行 sed '/error/d' file.txt:删除包含 “error” 的行 |
n |
读取下一行并替换当前模式空间 | sed -n '1n;p' file.txt:打印第 2 行 |
a |
在匹配行后追加内容 | sed '/^root/a newuser' file.txt:在以 “root” 开头的行后追加 “newuser” |
i |
在匹配行前插入内容 | sed '/^root/i # comment' file.txt:在以 “root” 开头的行前插入注释 |
c |
替换匹配行内容 | sed '2c new content' file.txt:将第 2 行替换为 “new content” |
sed核心应用
- sed-查找p
| 查找格式 | |
|---|---|
| ‘1p’ ‘2p’ | 指定行号打印 |
| ‘1, 5p’ | 指定范围打印, 最后一行用$表示 |
| ‘/Anthony/p’ | 正则匹配Anthony,包含Anthony的行打印 |
| ‘/59:01/, /59:49/p’ | 打印包含这两个字符串的行之间的内容 |
[root ~]# sed -n '1p' log
2022-03-01 14:58:46 [INFO] User logged in successfully.
[root ~]#
[root ~]#
[root ~]# sed -n '1, 5p' log
2022-03-01 14:58:46 [INFO] User logged in successfully.
2022-03-01 14:59:01 [WARNING] Low disk space, please clean up files.
2022-03-01 14:59:05 [ERROR] Server crashed due to memory leak.
2022-03-01 14:59:07 [DEBUG] Checking memory usage...
2022-03-01 14:59:10 [INFO] All servers are running smoothly now.
[root ~]#
[root ~]#
[root ~]# sed -n '/ERROR/p' log
2022-03-01 14:59:05 [ERROR] Server crashed due to memory leak.
2022-03-01 14:59:20 [ERROR] Unauthorized access attempt on user account.
2022-03-01 14:59:31 [ERROR] Failed to connect to database server.
2022-03-01 14:59:43 [ERROR] Data corruption detected, please restore from backup.
2022-03-01 14:59:56 [ERROR] Insufficient permissions to perform critical task
[root ~]#
[root ~]#
[root ~]# sed -n '/59:01/, /59:49/p' log
2022-03-01 14:59:01 [WARNING] Low disk space, please clean up files.
2022-03-01 14:59:05 [ERROR] Server crashed due to memory leak.
2022-03-01 14:59:07 [DEBUG] Checking memory usage...
2022-03-01 14:59:10 [INFO] All servers are running smoothly now.
2022-03-01 14:59:15 [WARNING] Multiple failed login attempts detected.
2022-03-01 14:59:20 [ERROR] Unauthorized access attempt on user account.
2022-03-01 14:59:23 [DEBUG] Logging out user account for security reasons.
2022-03-01 14:59:26 [INFO] User session timed out due to inactivity.
2022-03-01 14:59:28 [WARNING] Server overload detected, please try again later.
2022-03-01 14:59:31 [ERROR] Failed to connect to database server.
2022-03-01 14:59:33 [DEBUG] Checking network connection...
2022-03-01 14:59:36 [INFO] All systems are back online now.
2022-03-01 14:59:39 [WARNING] Outdated software version detected, please update as soon as possible.
2022-03-01 14:59:43 [ERROR] Data corruption detected, please restore from backup.
2022-03-01 14:59:46 [DEBUG] Analyzing log files for clues...
2022-03-01 14:59:49 [INFO] System upgrade complete, all services are running smoothly.
-
表示范围过滤的时候,如果结尾匹配不到,就会一直显示到最后一行
-
sed-删除d
| 查找格式 | |
|---|---|
| ‘1d’ ‘2d’ | 指定行号删除 |
| ‘1, 5d’ | 指定范围删除, 最后一行用$表示 |
| ‘/Anthony/d’ | 正则匹配Anthony,包含Anthony的行删除 |
| ‘/59:01/, /59:49/d’ | 删除包含这两个字符串的行之间的内容 |
- sed-增加cai
| 命令 | 含义 |
|---|---|
| c | 替换整行 |
| a | Append 追加,向指定的行追加内容(行下) |
| i | Insert 插入,向指定的行或每一行插入内容(行上) |
- sed-替换s
| sed | -s | ‘s/old/new/g’ | file.txt | 支持扩展正则 | | — | — | — | — | — |
g:global,全局替换。sed默认只替换每行第一个
- sed-后向引用
后向引用,如其名,就是引用的意思。
在正则表达式中,用()括起来的内容可以认为是一个变量,可以被引用。从左向右按顺序编号,编号从1开始。引用时使用\1引用。
举个例子:交换Anthony_4926中的两部分,使其变成4926_Anthony
[root ~]# echo Anthony_4926 | sed -r 's/([a-zA-Z]*)_([0-9]*)/\2_\1/g'
4926_Anthony
Awk
执行过程
awk -F, 'BEGIN{}条件{} END{}' log.txt
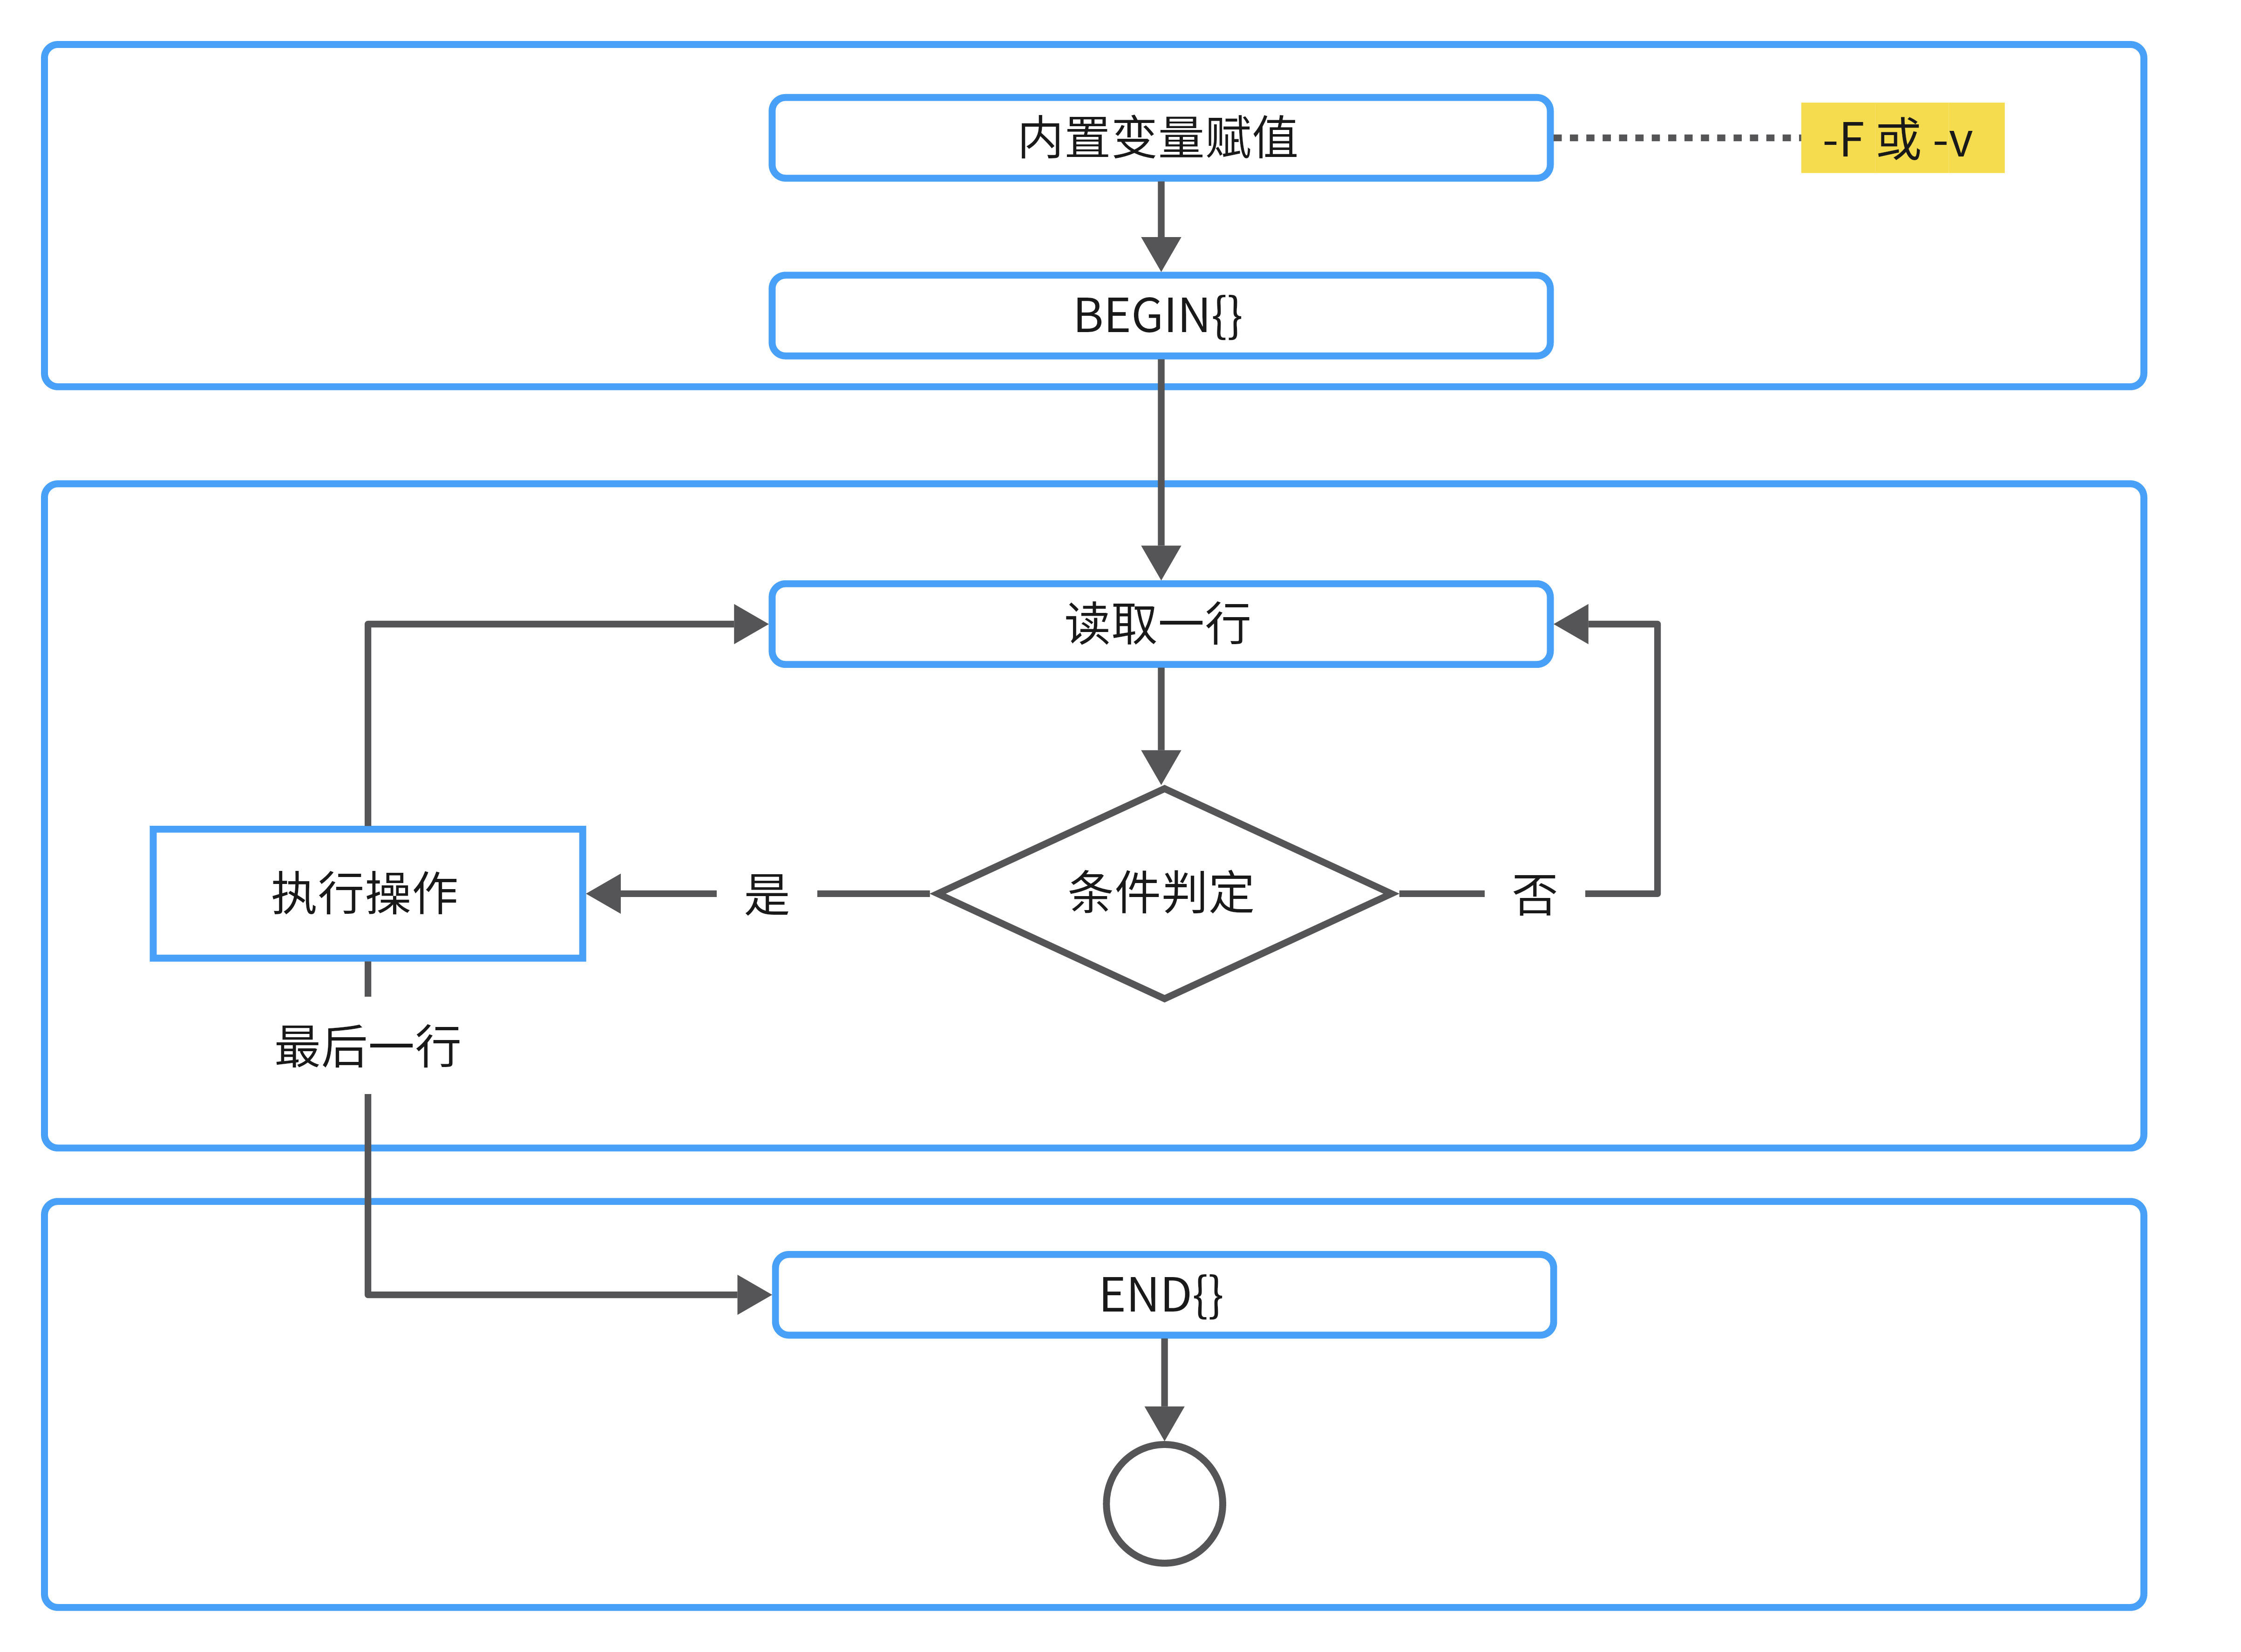
-v : 用来修改内置变量
awk内置变量
| 内置变量 | ||
|---|---|---|
| NR | Number of Record | 行号 |
| NF | Number of Filed | 列的数量,表示最后一列 |
| FS | -F: 相当于 -v FS=: |
输入分割符 |
| OFS | 输出分隔符 |
取行
| 条件 | |
|---|---|
| ‘NR==1’ | |
| ‘NR>2 && NR <= 5’ | |
| ‘/Anthony/’ | 正则匹配 |
| ‘/from/end/’ | 正则范围匹配 |
取列
- -F 指定分隔符,指定每一列的结束标记,默认是空格,tab
$数字取出某一列$0整行的内容- {print xxx}
$NF表示最后一列- ~ 列包含
- !~ 列不包含
基本示例
- 打印所有行:
echo "one two three" | awk '{print}'
- 或简化为:
awk '{print}' file.txt
输出文件 file.txt 中的所有行。
- 打印特定字段:
cat employees.txt | awk '{print $1, $3}'
默认以空格为分隔符,输出 employees.txt 文件中每一行的第一列和第三列。
- 使用自定义分隔符:
awk -F: '{print $1}' /etc/passwd
-F: 指定冒号为分隔符,输出 /etc/passwd 文件中每一行的用户名(第一字段)。
- 基于模式打印:
awk '/101/ {print}' somefile.txt
在 somefile.txt 中打印包含数字 101 的所有行。
- 打印行号、字段数及特定字段:
awk '{print NR, NF, $1, $NF}' file.txt
输出 file.txt 中的每一行及其对应的行号 (NR)、字段数 (NF)、第一字段 ($1) 以及最后一个字段 ($NF)。
- 对字段进行运算:
awk '{sum += $1} END {print sum}' numbers.txt
计算 numbers.txt 文件中每行第一个字段的总和。
更复杂的示例
- 设置变量:
awk -v var="Hello" '{print var, $0}' file.txt
使用 -v 参数设置变量 var,并在每行前打印该变量值。
- 多行处理:
awk '/^Start/,/^End/ {print}' logfile.log
输出 logfile.log 中从 Start 开始到 End 结束之间的所有行。
编写脚本:
BEGIN { FS="," } # 设置字段分隔符为逗号
{ print $1*$2 }   # 对每行的第一列和第二列相乘并打印
该脚本可以用来处理逗号分隔的CSV文件,计算两列数值的乘积。
主线到此结束。 到这里,日常操作、改配置、写脚本、处理文本这四件事都能自己搞定了。
忘了命令参数就回 linux 常用命令 查。